Chuyển đổi dữ liệu là quá trình bạn trích xuất dữ liệu, sàng lọc dữ liệu, hiểu dữ liệu và sau đó biến đổi nó thành thứ mà bạn có thể phân tích. Là một giai đoạn quan trọng của quy trình ETL, việc chuyển đổi dữ liệu là cần thiết để thay đổi thông tin thành một định dạng hoặc lược đồ mà nền tảng kinh doanh thông minh có thể tương tác để thu được những insights hữu ích để triển khai chiến dịch kinh doanh.
Chuyển đổi dữ liệu là gì?
Dữ liệu thô hoặc dữ liệu nguồn thường là:
- Không nhất quán: Nó chứa cả dữ liệu có liên quan và không liên quan.
- Không chính xác: Nó chứa thông tin được nhập không chính xác hoặc giá trị bị thiếu.
- Lặp đi lặp lại: Nó chứa dữ liệu trùng lặp.
Chuyển đổi dữ liệu là quá trình trích xuất dữ liệu tốt, đáng tin cậy từ các nguồn này. Điều này liên quan đến việc chuyển đổi dữ liệu từ một cấu trúc (hoặc không có cấu trúc) sang cấu trúc khác để bạn có thể tích hợp nó với kho dữ liệu của mình. Nó cho phép bạn hiển thị thông tin với các công cụ BI tiên tiến để tạo báo cáo có giá trị và dự báo xu hướng trong tương lai.
Quá trình chuyển đổi dữ liệu
Chuyển đổi dữ liệu bao gồm hai giai đoạn chính: hiểu và lập bản đồ dữ liệu; và chuyển đổi dữ liệu.
Giai đoạn 1: Hiểu và lập bản đồ dữ liệu
Trong giai đoạn đầu tiên của quá trình chuyển đổi dữ liệu, bạn sẽ xác định và nghiên cứu các nguồn dữ liệu của mình. Ví dụ về các nguồn dữ liệu bao gồm:
- Cơ sở dữ liệu gắn liền với các hệ thống kinh doanh khác nhau
- Phần mềm kế toán
- Nền tảng CRM
- Nguồn phát trực tuyến
- Tệp nhật ký khách hàng
- Dữ liệu ứng dụng web
- Thông tin liên quan đến thống kê sử dụng ứng dụng dành cho thiết bị di động
Sau khi xác định các nguồn dữ liệu của mình, bạn sẽ xác định loại cấu trúc dữ liệu mà mỗi nguồn có và các loại biến đổi cần thiết để kết nối chúng. Một số câu hỏi bạn có thể muốn hỏi là:
- Các cột và hàng trông như thế nào?
- Chúng được dán nhãn như thế nào?
- Chúng chứa những loại thông tin nào?
- Mối quan hệ giữa thông tin trong nguồn dữ liệu này liên quan đến một nguồn khác như thế nào?
Tiếp theo, bạn sẽ thực hiện lập bản đồ dữ liệu để xác định cách các trường trong các nguồn dữ liệu khác nhau kết nối với nhau và loại biến đổi dữ liệu nào cần thực thực hiện.
Giai đoạn 2: Chuyển đổi dữ liệu
Trong giai đoạn thứ hai của quá trình chuyển đổi dữ liệu, bạn sẽ thực hiện các phép biến đổi dữ liệu khác nhau mà bạn đã ánh xạ trong giai đoạn đầu tiên.
Các loại chuyển đổi dữ liệu
Dưới đây các loại chuyển đổi mà bạn, nền tảng ETL hoặc nhóm dữ liệu của bạn có thể cần thực hiện trong quá trình ETL. Mặc dù phần lớn các tác vụ này có thể diễn ra tự động với nền tảng chuyển đổi dữ liệu, nhưng đôi khi bạn có thể cần phải tự thiết lập và viết công thức tùy theo các quy trình ETL.
1. Bucketing/Binning (Nhóm dữ liệu)
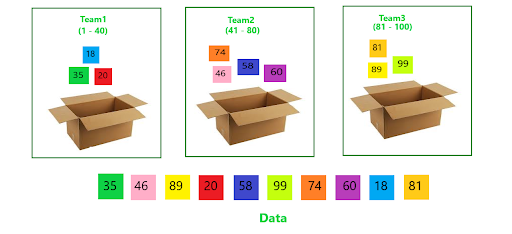
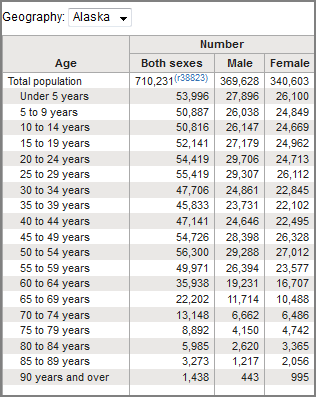
Bucketing hoặc binning được sử dụng để nhóm các giá trị dữ liệu riêng lẻ vào các nhóm cụ thể để “đóng thùng 1 nhóm dữ liệu” theo các tiêu chí xác định. Ví dụ: dữ liệu điều tra dân số có thể được phân loại thành các nhóm tuổi xác định.
2. Data Aggregation (Tổng hợp dữ liệu)
Tổng hợp dữ liệu là một quá trình tìm kiếm, thu thập, tóm tắt và trình bày dữ liệu trong các báo cáo khác nhau. Ví dụ, bạn có một danh sách các nhân viên nam và nữ và mức lương của họ, và bạn muốn biết tổng lương của nam so với tổng lương của nữ. Bạn có thể tổng hợp danh sách theo nam và nữ, sau đó tổng hợp tổng lương của từng nhóm.
Bạn có thể sử dụng nền tảng BI để thực hiện tổng hợp dữ liệu dựa trên thông tin chi tiết hoặc bạn có thể thực hiện tổng hợp thủ công bằng cách viết mã trong SQL
3. Data Cleansing (Làm sạch dữ liệu)
Làm sạch dữ liệu bao gồm việc xóa thông tin lỗi thời, không chính xác hoặc không đầy đủ để tăng độ chính xác của dữ liệu. Làm sạch dữ liệu dựa trên việc phân tích cẩn thận các tập dữ liệu và các giao thức lưu trữ dữ liệu để cung cấp dữ liệu chính xác nhất có thể. Quá trình này có thể bao gồm phân tích cú pháp dữ liệu để loại bỏ lỗi cú pháp, xóa các đoạn bản ghi và sửa lỗi chính tả. Nó cũng có thể liên quan đến việc sửa chữa các vấn đề trùng lặp do hợp nhất nhiều tập dữ liệu.

4. Data Deduplication (Loại bỏ dữ liệu trùng lặp)
Loại bỏ dữ liệu trùng lặp là một quá trình nén dữ liệu trong đó bạn xác định và loại bỏ các bản sao thông tin trùng lặp hoặc lặp lại. Còn được gọi là lưu trữ đơn thể hiện, nén thông minh hoặc giảm dữ liệu, tính năng chống trùng lặp dữ liệu cho phép bạn lưu trữ một bản sao dữ liệu duy nhất trong kho dữ liệu hoặc cơ sở dữ liệu của mình.
Quá trình loại bỏ dữ liệu trùng lặp sẽ phân tích dữ liệu đến và so sánh nó với dữ liệu đã được lưu trữ trong hệ thống. Nếu dữ liệu đã có ở đó, các thuật toán loại bỏ trùng lặp sẽ xóa thông tin trùng trong khi tạo tham chiếu đến nó. Nếu bạn tải lên phiên bản đã thay đổi của tệp trước đó, hệ thống sẽ sao lưu tệp đó trong khi thêm các thay đổi vào phân đoạn dữ liệu. Các thuật toán trùng lặp cũng theo dõi dữ liệu gửi đi để xóa các dữ liệu trùng lặp, giúp tăng tốc quá trình truyền thông tin.

5. Data Derivation (Lấy dữ liệu)
Phương thức lấy dữ liệu liên quan đến việc tạo ra các quy tắc đặc biệt để “lấy” thông tin cụ thể mà bạn muốn từ nguồn dữ liệu. Ví dụ: bạn có cơ sở dữ liệu bao gồm dữ liệu tổng doanh thu từ việc bán hàng, nhưng bạn chỉ quan tâm đến số liệu lợi nhuận sau khi trừ đi chi phí và nghĩa vụ thuế. Kết xuất dữ liệu cho phép bạn tạo một tập hợp các quy tắc chuyển đổi trừ chi phí và thuế khỏi thông tin tổng doanh thu.
6. Data Filtering (Lọc dữ liệu)
Lọc dữ liệu bao gồm các kỹ thuật được sử dụng để tinh chỉnh các tập dữ liệu. Mục tiêu của lọc dữ liệu là chắt lọc nguồn dữ liệu để lấy những gì người dùng cần bằng cách loại bỏ dữ liệu lặp lại, không liên quan hoặc quá nhạy cảm. Bộ lọc dữ liệu có thể được sử dụng như vậy để sửa đổi kết quả truy vấn và báo cáo dữ liệu.
Trên thực tế, lọc dữ liệu chỉ đơn giản là việc lựa chọn các hàng, cột hoặc trường cụ thể để hiển thị từ tập dữ liệu. Ví dụ: nếu người dùng không cần xem địa chỉ hoặc số An sinh xã hội của từng khách hàng trong báo cáo, thì tính năng lọc dữ liệu sẽ loại bỏ chúng khỏi báo cáo.

7. Data Integration (Tích hợp dữ liệu)
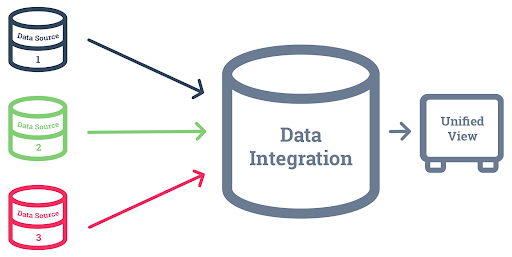
Tích hợp dữ liệu là quá trình lấy các kiểu dữ liệu khác nhau (như cơ sở dữ liệu và bộ dữ liệu khác nhau liên quan đến dữ liệu mà bạn cần) và hợp nhất chúng vào cùng một cấu trúc hoặc lược đồ. Phương thức tích hợp dữ liệu hỗ trợ việc phân tích các tập dữ liệu khổng lồ bằng cách hợp nhất nhiều nguồn dữ liệu thành một tổng thể dễ phân tích.
Về cốt lõi, việc tích hợp dữ liệu sẽ dung hòa các giá trị và các tên đề mục khác nhau mà thuộc về cùng 1 loại phần tử dữ liệu trong kho dữ liệu. Bằng cách đặt tên và định nghĩa tiêu chuẩn cho mỗi phần tử, tích hợp dữ liệu giúp phân tích thông tin với nền tảng kinh doanh thông minh BI.
8. Joining data (Ghép dữ liệu)
Ghép dữ liệu là một trong những chức năng quan trọng nhất của chuyển đổi dữ liệu. Ghép dữ liệu là một thao tác trong ngôn ngữ cơ sở dữ liệu SQL cho phép bạn kết nối hai hoặc nhiều bảng cơ sở dữ liệu bằng các cột phù hợp của chúng. Điều này cho phép bạn thiết lập mối quan hệ giữa nhiều bảng, kết hợp dữ liệu bảng với nhau để bạn có thể truy vấn dữ liệu tương quan trên các bảng.
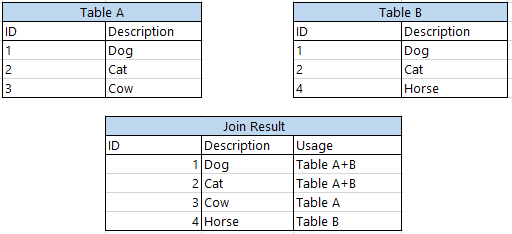
9. Data Splitting (Tách dữ liệu)
Tách dữ liệu có nghĩa là việc chia một cột thành nhiều cột. Phương thức này thường được áp dụng để phân tích dữ liệu có sẵn. Việc chia nhỏ dữ liệu có thể hữu ích với một lượng lớn dữ liệu được thu thập trong một khoảng thời gian.
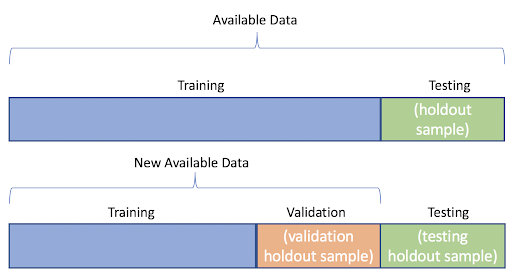
10. Data summarization (Thu gọn dữ liệu)
Data summarization (Thu gọn dữ liệu) tương tự như Data Aggregation (tổng hợp dữ liệu). Nó bao gồm việc tính toán tổng giá trị để tạo ra các số liệu kinh doanh khác nhau. Bạn có thể tổng hợp tổng doanh thu của tất cả các lần bán hàng được thực hiện bởi các nhân viên bán hàng riêng lẻ trong đội ngũ nhân viên của bạn, sau đó tạo các số liệu bán hàng cho biết tổng doanh số bán hàng cho từng khoảng thời gian.
11. Data Validation (Xác thực dữ liệu)
Xác thực dữ liệu là quá trình tạo ra các quy tắc hoặc thuật toán tự động để xử lý khi hệ thống gặp các vấn đề dữ liệu khác nhau. Xác thực dữ liệu giúp đảm bảo tính chính xác và đồng nhất của dữ liệu bạn chuyển đổi. Ví dụ: một quy tắc xác thực dữ liệu có hiệu lực khi hệ thống nhận thấy rằng ba trường đầu tiên trong một hàng bị trống (hoặc giá trị NULL). Quy tắc xác thực có thể gắn cờ ở hàng để người dùng cuối kiểm tra sau hoặc ngăn hệ thống xử lý tất cả hàng.
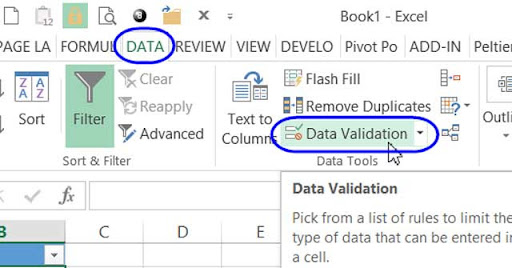
12. Format Revision (Sửa đổi định dạng)
Phương thức sửa đổi định dạng khắc phục sự cố xuất phát từ các trường có các kiểu dữ liệu khác nhau. Một số trường có thể là số và những trường khác có thể là văn bản. Một hệ thống dữ liệu có thể xử lý thông tin văn bản và thông tin số theo cách khác nhau, vì vậy bạn có thể phải chuẩn hóa các định dạng để tích hợp dữ liệu nguồn với lược đồ dữ liệu đích. Điều này có thể liên quan đến việc chuyển đổi nam / nữ, ngày / giờ, số đo và các thông tin khác sang một định dạng nhất quán.
Độ dài trường cũng có thể là một vấn đề — đặc biệt nếu lược đồ mục tiêu có giới hạn ký tự ít hơn. Trong những trường hợp này, có thể cần tiêu chuẩn hóa độ dài của các trường bằng cách chia nhỏ các số sê-ri dài thành các phần nhỏ hơn và đặt chúng vào các cột riêng biệt.
Ngoài ra, việc sửa đổi định dạng có thể liên quan đến việc chia danh sách các chữ cái hoặc số được phân tách bằng dấu phẩy thành nhiều cột.
13. Key Restructuring (Tái cấu trúc chính)
Khi các bảng trong kho dữ liệu có các dữ liệu được đặt làm key, gắn với ý nghĩa nhất định, có nhiều vấn đề có thể xảy ra với dữ liệu. Ví dụ: nếu số điện thoại của khách hàng đóng vai trò là key chính, việc thay đổi số điện thoại trong nguồn dữ liệu ban đầu có nghĩa là số đó sẽ phải thay đổi ở mọi nơi nó xuất hiện trong hệ thống dữ liệu. Điều đó sẽ gây ra một loạt các bản cập nhật gây quá tải hoặc làm chậm hệ thống.
Thông qua việc tái cấu trúc khóa, bạn có thể chuyển đổi bất key chính nào có ý nghĩa tích hợp thành key chung — tức là các số ngẫu nhiên tham chiếu trở lại cơ sở dữ liệu nguồn với thông tin thực tế. Bằng cách vẽ các kết nối chính từ bảng này sang bảng khác, việc tái cấu trúc quan trọng sẽ tối ưu hóa kho dữ liệu về tốc độ và hiệu quả.
14. Z-Score Normalization and Max-Min Scaling (Chuẩn hóa điểm Z và Tỷ lệ tối đa tối thiểu)
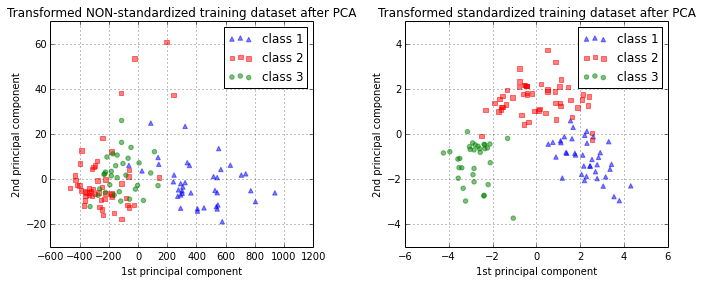
Chuẩn hóa dữ liệu là một phần thiết yếu của máy học. Bạn có thể có một tập dữ liệu tuyệt vời với nhiều tính năng tuyệt vời, nhưng nếu bạn quên chuẩn hóa, một trong những tính năng đó có thể hoàn toàn lấn át những tính năng khác. Nó giống như bạn đang vứt bỏ gần như tất cả thông tin của mình! Chuẩn hóa giải quyết vấn đề này với 2 kỹ thuật để chuẩn hóa dữ liệu là
- Chuẩn hóa tối thiểu tối đa: Đảm bảo tất cả các tính năng sẽ có cùng một tỷ lệ chính xác nhưng không xử lý tốt các ngoại lệ.
- Chuẩn hóa điểm Z: Xử lý các giá trị ngoại lệ, nhưng không tạo ra dữ liệu chuẩn hóa với cùng thang điểm chính xác.
Hy vọng qua bài viết này của Cole, các bạn có thể hiểu thêm về Mô hình thống kê và mối quan hệ của nó trong việc phân tích dữ liệu cũng như các Các kỹ thuật thống kê quan trọng trong phân tích dữ liệu. Để học hỏi và nắm chắc được kiến thức về Phân tích dữ liệu Data Analysis bạn có thể tham khảo Khóa học Data Analysis. Khóa học giúp bạn có nền tảng vững chắc về phân tích dữ liệu, làm chủ tư duy phân tích dữ liệu để có hướng đi đúng trong không gian dữ liệu nhiều chiều.


